Корисниците што ѝ се обраќаат на вештачката интелигенција на помалку застапени јазици можат да плаќаат повеќе од оние што користат англиски или други доминантни јазици, покажува ново истражување.
Причината е начинот на кој AI-моделите го обработуваат текстот. За одредени јазици им се потребни значително повеќе токени, основните единици податоци што ги обработува моделот, што кај услугите со наплата по токен ги зголемува трошоците, наведува „ROW“.
Истражувачите од Коалицијата за јазична рамноправност во истражувањето на вештачката интелигенција го нарекуваат овој проблем скриен „данок на токенизација“. Неговите последици не се однесуваат само на цената, туку и на брзината на работа и количеството информации што моделот може истовремено да ги обработи.
Зошто истата задача може да чини повеќе на друг јазик?
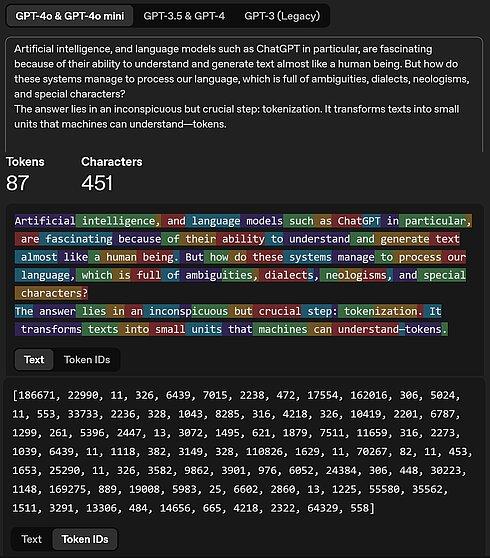
Токенизаторот е алатка што ја разложува влезната содржина, како текст, слика или звук, на единици што AI-моделот може да ги обработува.
Истражувањето објавено минатиот месец покажало разлики дури и меѓу 20-те најзастапени јазици на интернет. Најпребирливите во поглед на токени трошеле меѓу 1,5 и петпати повеќе токени од најекономичните.
Кога анализата била проширена на 200 јазици, разликите станале уште поизразени. Кај еден модел односот на трошоците достигнал 17 наспроти еден.
„Стартап во Бенгалуру може да плаќа дополнителен трошок за секое прашање и одговор, додека неговиот конкурент во Остин не мора“, се наведува во студијата.
Авторите предупредуваат дека поголемиот број токени значи и подолго чекање на одговор, како и помал ефективен простор за обработка на содржината.
„Овие последици најтешко ги погодуваат средините во кои компјутерските ресурси и поврзаноста веќе се ограничени. Нееднаквоста во токенизацијата ограничува кој може да учествува во економијата на вештачката интелигенција.“
Како јазикот може да влијае врз квалитетот на одговорите?
Пратјуш Чоудури, коосновач на фондот „Activate AI“, кој вложува исклучиво во вештачка интелигенција, објаснил дека јазиците што трошат повеќе токени оставаат помалку место за документи и за историјата на разговорот.
Фондот поддржува повеќејазични компании за гласовна AI, вклучувајќи ги „ElevenLabs“, „Sarvam“ и „Wispr Flow“.
Чоудури како пример навел дигитален наставник, за чија квалитетна работа е важно да ги задржи претходните грешки на ученикот и објаснувањата.
„Размислете за наставник: помнењето на претходните грешки на ученикот и објаснувањата е дел од квалитетната настава. Ако таа историја на еден јазик многу побрзо го исполнува контекстниот прозорец, недостатокот се одразува и врз квалитетот на услугата“, изјавил тој.
Контекстниот прозорец го претставува количеството содржина што моделот може истовремено да го земе предвид при одговарањето.
Зошто писмото е важно колку и застапеноста на јазикот?
Еден од начините за унапредување на јазичната обработка е подобрувањето на податоците врз кои се развиваат системите.
Раул Нанавати, коосновач и директор на компанијата „Navana.ai“ од Мумбај, за „Rest of World“ го издвоил значењето на отворените збирки податоци.
„Важни се иницијативите како ’RESPIN‘, заеднички проект со Индискиот институт за наука, финансиран од Фондацијата Гејтс. Во него собравме текстови од изворни говорители на 38 дијалекти, заедно со снимки од читан говор“, изјавил тој.
Сепак, истражувањето покажува дека бројот на говорители и количеството достапна содржина не се единствените фактори. Голема улога има и писмото.
Астурискиот јазик, и покрај релативно малиот број говорители и отсуството на податоци во збирката „Common Crawl“ опфатена со анализата, ги користи предностите на латиницата и застапеноста на сродните романски јазици, како италијанскиот.
Наспроти тоа, јазиците што се пишуваат со писма со кои токенизаторите ретко доаѓале во допир биле во најнеповолна положба кај речиси сите анализирани модели. Меѓу нив се бурманското и тибетското писмо, тифинаг, кмерското и лаоското писмо, како и ол чики.
Можат ли поквалитетните податоци да го решат проблемот?
Многу од денешните токенизатори се несразмерно приспособени на англискиот и на другите јазици со изобилство дигитални содржини, смета Димант Реди, директор на компанијата „Maya Research“.
Оваа компанија развива разговорни AI-модели наменети за следните милијарди корисници на интернет, со цел да зборуваат и да одговараат природно, како изворни говорители.
Реди предупредува дека поквалитетните податоци за обука сами по себе не го подобруваат токенизаторот.
„Цените на токените многу брзо паѓаат, па директното влијание врз трошоците со текот на времето би требало да биде помало. Поквалитетните повеќејазични и синтетички податоци би требало да ги унапредат моделите. Но вистинското намалување на разликите во токенизацијата ќе бара лабораториите идните токенизатори намерно да ги проектираат така што подобро ќе ги обработуваат тие јазици и писма“, изјавил тој.
Што би требало да објавуваат AI-компаниите?
Чоудури смета дека јазичната ефикасност треба да биде едно од основните барања при развојот на производите, покрај точноста, брзината и сигурноста.
„Совршената еднаквост можеби не е реална. Сепак, големите и трајни разлики би требало да бараат објаснување и план за подобрување“, порачал тој.
Ги повикал големите AI-лаборатории да објавуваат споредбени резултати за секој јазик, со приказ на трошоците за успешно извршување слични задачи.
Покрај тоа, според него, би требало да се обврзат на мерливи подобрувања за јазиците чии корисници моментално се во најнеповолна положба.